Auto 智能编排:一种 Lead 驱动的多智能体执行协议
用户给编码智能体的指令通常很短,也很少足够精确;模型在信息不足时倾向于大范围读取代码,使主上下文被与决策无关的内容占据。Auto 是 Piwin 内置的一种编排方案,它不增加新的"智能",而是把软件工程中的分工、隔离、审查与验证固化为 Host 可执行的协议:主代理(Lead)先陈述目标并按最小读取原则取证;高噪声的探索交给只读的 Scout,在独立上下文中完成;已定方案的机械实现交给唯一的写者 Sidekick,在独立工作树中产出候选改动;改动超过规模阈值时必须经过独立 Reviewer;合入后由 Tester 在工作区快照中后台验证。
本文说明这四条约束各自针对什么问题、依据是什么,以及它们的适用边界。
1 引言:从 Ultra 与 Fusion 到 Auto
Piwin 的编排模式不是多代理角色扮演,而是一套可选择的工程执行协议。用户在发送每条消息前选定一种编排方案,Host 随即把对应的主代理纪律、角色名册、并发边界、隔离方式、审查规则与交付流程注入本次运行。
在 Auto 之前,Piwin 已有两种方案,它们现在是 Auto 的组成部分(见 §2.2、§2.3):
- Ultra Code:主代理派出只读的 Scout 先行侦察,再基于报告动手,适合排查问题;
- Fusion:强模型(Lead)负责规划与终审,高性价比模型(Sidekick)负责执行,适合实现新功能。
两者单独使用时存在一个共同的缺陷:方案的选择权被交还给了用户。"排查问题用 Ultra、写新功能用 Fusion"是一条过于粗糙的经验法则,真实任务往往先要定位、再要实现、最后还要验证,中途切换方案既不自然,也没有人会去做。
Auto 的出发点因此有两个:
- 合并:把 Ultra 的取证能力与 Fusion 的分工结构放进同一个方案,由 Lead 根据任务当前的状态决定下一步交给谁;
- 约束:用一组 harness 规则限定 Lead 的行为。用户往往无法提供足够准确的提示词,却期望一句话解决问题;在这种输入条件下,与其指望模型自行把握分寸,不如让它在明确的工程约束内决策。
2 设计总览
2.1 角色与流转
Auto 并不是第四套独立的编排器。它引用已有方案的角色——Scout 来自 Ultra Code,Sidekick 来自 Fusion,Reviewer 来自 Reviewed Delivery——只新增了 Tester。修改 Ultra 中 Scout 的模型配置,Auto 会随之生效。
图 3 给出一次任务在各角色之间的完整流转,可点选任一阶段查看细节。
Lead 动手前先输出一行 [Goal] 与最小读取集。意图识别错了,用户在这一步就能打断并补充信息。
各角色的职责边界如下:
| 角色 | 职责 | 权限与隔离 | 并发 |
|---|---|---|---|
| Lead | 理解需求、路由、处理歧义、终审、对用户交付 | 主会话,持有完整上下文 | — |
| Scout | 定位符号、追踪调用、扫描大文件,返回带 file:line 的证据 | 只读,独立上下文 | 可并行 |
| Sidekick | 对已定方案做机械实现,报告 done / blocked / escalate | 可写,独立 worktree,看不到主会话历史 | 1 |
| Reviewer | 对一份冻结的候选改动做独立审查 | 只读 | 按需 |
| Tester | 合入后验证真实行为并给出证据 | 工作区快照,改动永不合入 | 每会话至多 1 个 |
路由决策始终由 Lead 做出,Host 不对任务做题型分类。Host 只强制执行一道客观闸门:改动规模超过阈值时必须经过独立 Reviewer(见 §6.3)。
2.2 子方案一:Ultra Code
Ultra Code 是 Auto 中取证部分的来源,面向中大型代码库里"先弄清楚再动手"的任务。
[用户需求] ──> [主代理]
                  │ 派发有界问题
                  ▼
        [Scout 只读侦察] ──深入代码库──> [定位符号 · 追踪调用 · 评估风险]
                  │
                  ▼ 带 file:line 的结构化报告
[主代理] ──抽查引用──> [在干净的上下文中修改]- Scout 以只读方式进入代码库,只负责梳理接口定义、调用关系与潜在风险,输出结构化报告;
- 主代理审阅报告后再动手,避免"边搜边改"把搜索过程中的全部中间产物留在主上下文里。
它解决的问题与依据在约束二中展开。
2.3 子方案二:Fusion
Fusion 是 Auto 中分工部分的来源:强模型做规划与终审,高性价比模型做执行。
┌──────────────────────────────────┐
│  Lead(主会话)                   │
│  理解需求 → 拆解任务 → 审查结果   │
└──────────────────────────────────┘
        │ brief(自包含任务简报)
        ▼
┌──────────────────────────────────┐
│  Sidekick(独立子会话)           │
│  · 独立 Git worktree 中写代码     │
│  · 在 worktree 内运行测试与构建   │
│  · 提交候选改动 candidate         │
└──────────────────────────────────┘
        │ Lead 审查通过后应用
        ▼
┌──────────────────────────────────┐
│  用户工作区                       │
└──────────────────────────────────┘- 简报隔离:Sidekick 只能看到分配给它的 brief,看不到主会话的历史;
- 写入隔离:所有文件写入发生在独立的 Git worktree 中,主工作区不会出现半成品;
- 显式合入:候选改动经 Lead 审查批准后才应用到工作区。
2.4 Auto 在两者之上增加了什么
| 来源 | 进入 Auto 的部分 | Auto 的补充 |
|---|---|---|
| Ultra Code | Scout 及其只读契约 | 必须先说明"答案如何改变计划"才能派出 Scout |
| Fusion | Lead / Sidekick 分工、worktree、单写者 | 规模闸:超限改动强制独立审查 |
| Reviewed Delivery | 独立的只读 Reviewer | 仅在超过规模闸时启用 |
| Auto 自身 | — | 常驻的 Goal 行与最小读取纪律;后台 Tester |
Ultra Code 与 Fusion 仍可在编排下拉中单独选用,适合只想要其中一种行为的场合;一般情况下直接使用 Auto 即可,由 Lead 决定何时取证、何时交给 Sidekick。
下面依次讨论 Auto 的四条约束。
3 约束一:先陈述目标,再按最小读取原则取证
Lead 在采取任何行动之前,必须先输出一行内容:目标(Goal),以及为达成目标所需的最小读取集或需要启动的 Scout。
这条规则包含两个部分,各自针对一个问题。
3.1 Goal 行:把意图识别变成可检查的输出
模型对一句话需求的理解是否正确,在传统流程中要等到它产出结果才能判断,此时已经消耗了大量时间与 token。Goal 行把意图识别提前为第一个可见输出:理解有偏差,用户可以立即暂停并补充信息,纠错成本降到最低。
3.2 最小读取:每一次读取都必须能改变答案
当前相当一部分模型存在过度思考与无目的重复读取的倾向,在提示词不够精确时尤其明显。Auto 对信息收集阶段施加了严格限制:
- 每一次新的读取或搜索,都必须有可能改变当前的结论,否则跳过;
- 答案一旦确定即停止收集,不做"保险起见再看一眼"式的读取;
- 主线程内不做全仓库 grep 或扫描,不读无关的相邻目录、旧快照、备份副本;
- 确实需要大范围搜索时,只能通过 Scout 进行,并且必须先说明"这个问题的答案会如何改变计划"。
需要强调的是,严格限制只作用于信息收集。对改动的验证不受此约束,那是 Reviewer 与 Tester 的职责。
规则来源
这条规则改编自 LINUX DO 社区讨论 《如何在 DSH 里提高 DS4.1F 的效率,根治多动症和发散行为》中分享的 agent.md,并与 Karpathy 的编码准则做了合并。
4 约束二:隔离高噪声探索,抑制上下文污染
Piwin 中的 code_search 工具与 Scout 子代理服务于同一个目标:减少进入主上下文的无关内容。
4.1 术语说明
本文把"与当前决策无关、却持续占据主上下文的内容"称为上下文污染。这是原帖为了便于讨论而使用的非正式说法。业界对同类现象已有若干相近的表述,例如 context rot(上下文腐化)[4],以及对失效模式的进一步细分:context poisoning、distraction、confusion、clash[5]。本文不严格区分这些概念,统一使用"上下文污染"。
观察任意一次智能体运行的调用链路,出现最频繁的工具几乎总是 Grep 与 Read。一个典型的长思考模型的工作轨迹是:
读取目录树 → 读取大量文件 → 其中相当一部分是无关实现 → 运行测试
所有这些产物——有用的与无用的——都落在同一个上下文里。上下文是模型做出每一步决策的全部依据,因此污染的代价不是"占了点空间",而是直接作用于决策质量。
更关键的一点是:上下文膨胀的大头通常不是模型的推理文字,而是旧的工具输出。JetBrains Research 在 SWE-agent 上的统计显示,观察结果(文件内容、命令输出等)平均约占每轮 token 的 84%[9]。换言之,主会话每多读一次无关文件、多跑一次冗长命令,后续每一轮都会带着这笔噪声继续计费、继续抢注意力——污染会自我放大,而不是只发生在"读完那一下"。
4.2 四种退化机制
(1)注意力稀释。 假设探索阶段读取了 30 个文件,而真正需要修改的只有 4 个。这 4 个文件的内容必须与其余 26 个文件竞争模型的注意力。关于长上下文的研究表明,相关信息在上下文中的位置与周围干扰内容的数量,都会显著影响模型对它的利用效果[4][6]。
(2)错误线索残留。 探索过程中的自我否定("等等,我发现……")、重复查询、以及读到的旧实现,都会留在上下文中。即使模型随后推翻了这些线索,它们仍是后续每一步推理的输入。影响的权重也许不大,但不为零。
(3)推理状态混乱。 排查问题时,模型会产生一连串中间假设:"可能是 A → 不对 → 可能是 B → 又排除"。这些假设构成了冗长而低价值的上下文。此时主动压缩(compact)一次通常会改善效果,但实践中很少有人这样做,因为会话仍在工作。
(4)成本累积。 上述内容会随每一次后续请求被重复携带。即使命中缓存,多数计费方式下缓存读取仍然收费;上下文越堆越大,每一轮的固定开销随之上升。
这四种机制叠加的结果是:上下文即使远未触及窗口上限,有效信息密度也已显著下降——模型很难在大量内容中定位到关键的决策依据。图 5 用一个简单的计数模型说明这一点。
所有搜索、试读与中间假设都直接落在左侧。
4 个相关文件要与 26 个无关文件竞争注意力,并且这些无关内容会随每一次后续请求被重复携带。
4.3 为什么不能简单地缩小上下文窗口
既然内容越多越容易稀释,一个直觉上的对策是使用较小的窗口并频繁压缩。部分工具默认采用 256K 左右的窗口,信息密度的考虑可能是原因之一。但缩小窗口并不能解决问题,长上下文有其不可替代的价值:
检索的完整性。 当前主流模型的工作方式就是长时间思考与检索,一二十分钟的代码库探索并不罕见。窗口过小时,探索尚未结束、模型还不清楚哪些代码是关键的,压缩就已经被触发。
压缩是有损的。 压缩是上下文管理中最关键的环节。以 Pi 的实现为例:每次保留一定数量的近期 token,对更早的内容做渐进式摘要。摘要必然丢弃一部分信息,而"哪些可以丢弃"本身就是一个困难的判断。窗口越小,被迫摘要的内容越多,丢失的原始证据也越多;窗口足够大,才能保留更多原始证据。此外,部分模型能够感知自身剩余的上下文预算,据社区观察,它们在窗口接近用尽时的决策会趋于保守。
长任务的需要。 用户经常把一份很长的文档交给模型,期望它处理好每一个细节。完整读入长文档的能力是这类任务的前提。
多工具的需要。 智能体接入的工具越来越多,工具返回是决策信息的重要来源。在难以事先判断哪些返回重要的情况下,尽量保留是更稳妥的策略。
于是出现了一对矛盾:
问题不在于窗口多大,而在于让什么内容进入主上下文。
4.4 Scout:检索子代理与信息压缩器
子代理最初被引入的目的就是上下文隔离。代码搜索与分析、大量的 shell 输出、浏览器的 DOM 快照与截图——这些操作都会产生大量中间噪声。把它们放进子代理,子代理在自己的上下文中消化这些噪声,只向主代理返回一份摘要。
结合 4.1 的定量事实就更清楚了:若每轮上下文约有 84% 是观察结果,那么"主模型自己去搜、自己去读"等于把膨胀主力直接堆进 Lead 的决策窗口。Scout 要解决的,正是把这部分高噪声、低决策密度的 token 挪出主会话。
Scout 可以被理解为**"检索子代理 + 信息压缩器"**的组合,其好处可以概括为四条:
- 噪声不出主会话。 它消耗的是自己的上下文,任务结束即丢弃;读了多少文件、跑了多少命令,都不进入 Lead 的历史。
- 回传的是证据,不是原文。 返回带
file:line引用的结构化报告,而不是整文件、整段日志;Lead 抽查几处引用即可,不必重复 Scout 已做过的搜索。 - 保护决策带宽。 Lead 的注意力留给目标、路由、取舍与终审;84% 量级的观察 token 不再与真正要改的那几处代码抢位,有效信息密度得以维持(对照图 5)。
- 成本结构更合理。 探索本身可以交给更快、更便宜的模型;总 token 未必变少,但昂贵的主模型少背旧工具输出,后续每一轮的固定开销不再被探索噪声拖着涨。
与图 5 对照:Scout 读取多少文件,都不改变主上下文中的条目数。4.3 节的矛盾由此得到缓解——主上下文保持足够大的窗口以保留原始证据,同时只接收经过筛选的内容。
Auto 对 Scout 的使用也设了边界:每个 Scout 只回答一个有界的问题,Lead 必须说明该问题的答案为何会改变计划;Scout 不修改代码、不做架构决策、不再派生子代理。
4.5 业界的一致做法
上述判断并非 Piwin 独有,近一年的公开资料已基本形成共识:
- OpenAI 的多智能体指南把子代理架构描述为绕开上下文限制的一种方式:子代理可以自行探索数万乃至数十万 token,最终只向主代理返回约 1–2k token 的精炼摘要[1]。
- Cursor 的 Subagents 文档指出,代码库探索会产生大量中间输出并使主上下文膨胀,因此将其放入独立上下文。Cursor 内置的三个子代理——
Explore(代码搜索与分析)、Bash(大量 shell 输出)、Browser(DOM 快照与截图)——恰好都是高噪声工具的代理[2]。 - Anthropic 在关于上下文工程的文章中同样建议:子代理在独立上下文中完成深入探索,只返回压缩后的摘要[3]。
- JetBrains Research 进一步给出了软件工程场景下的 token 构成:SWE-agent 轨迹中,观察结果平均约占每轮的 84%,说明上下文管理应优先针对工具输出,而不是只压缩模型自己的推理文字[9]。Scout 把整段探索放到独立上下文,相当于在编排层先做了一次更彻底的"观察隔离"——噪声甚至不会进入主会话,而不是事后再掩码或摘要。
5 约束三:判断与执行分离
Auto 的角色分工继承自 Fusion,其思路来自 Devin 的同名设计:由强模型主导规划,配以高性价比的执行模型。
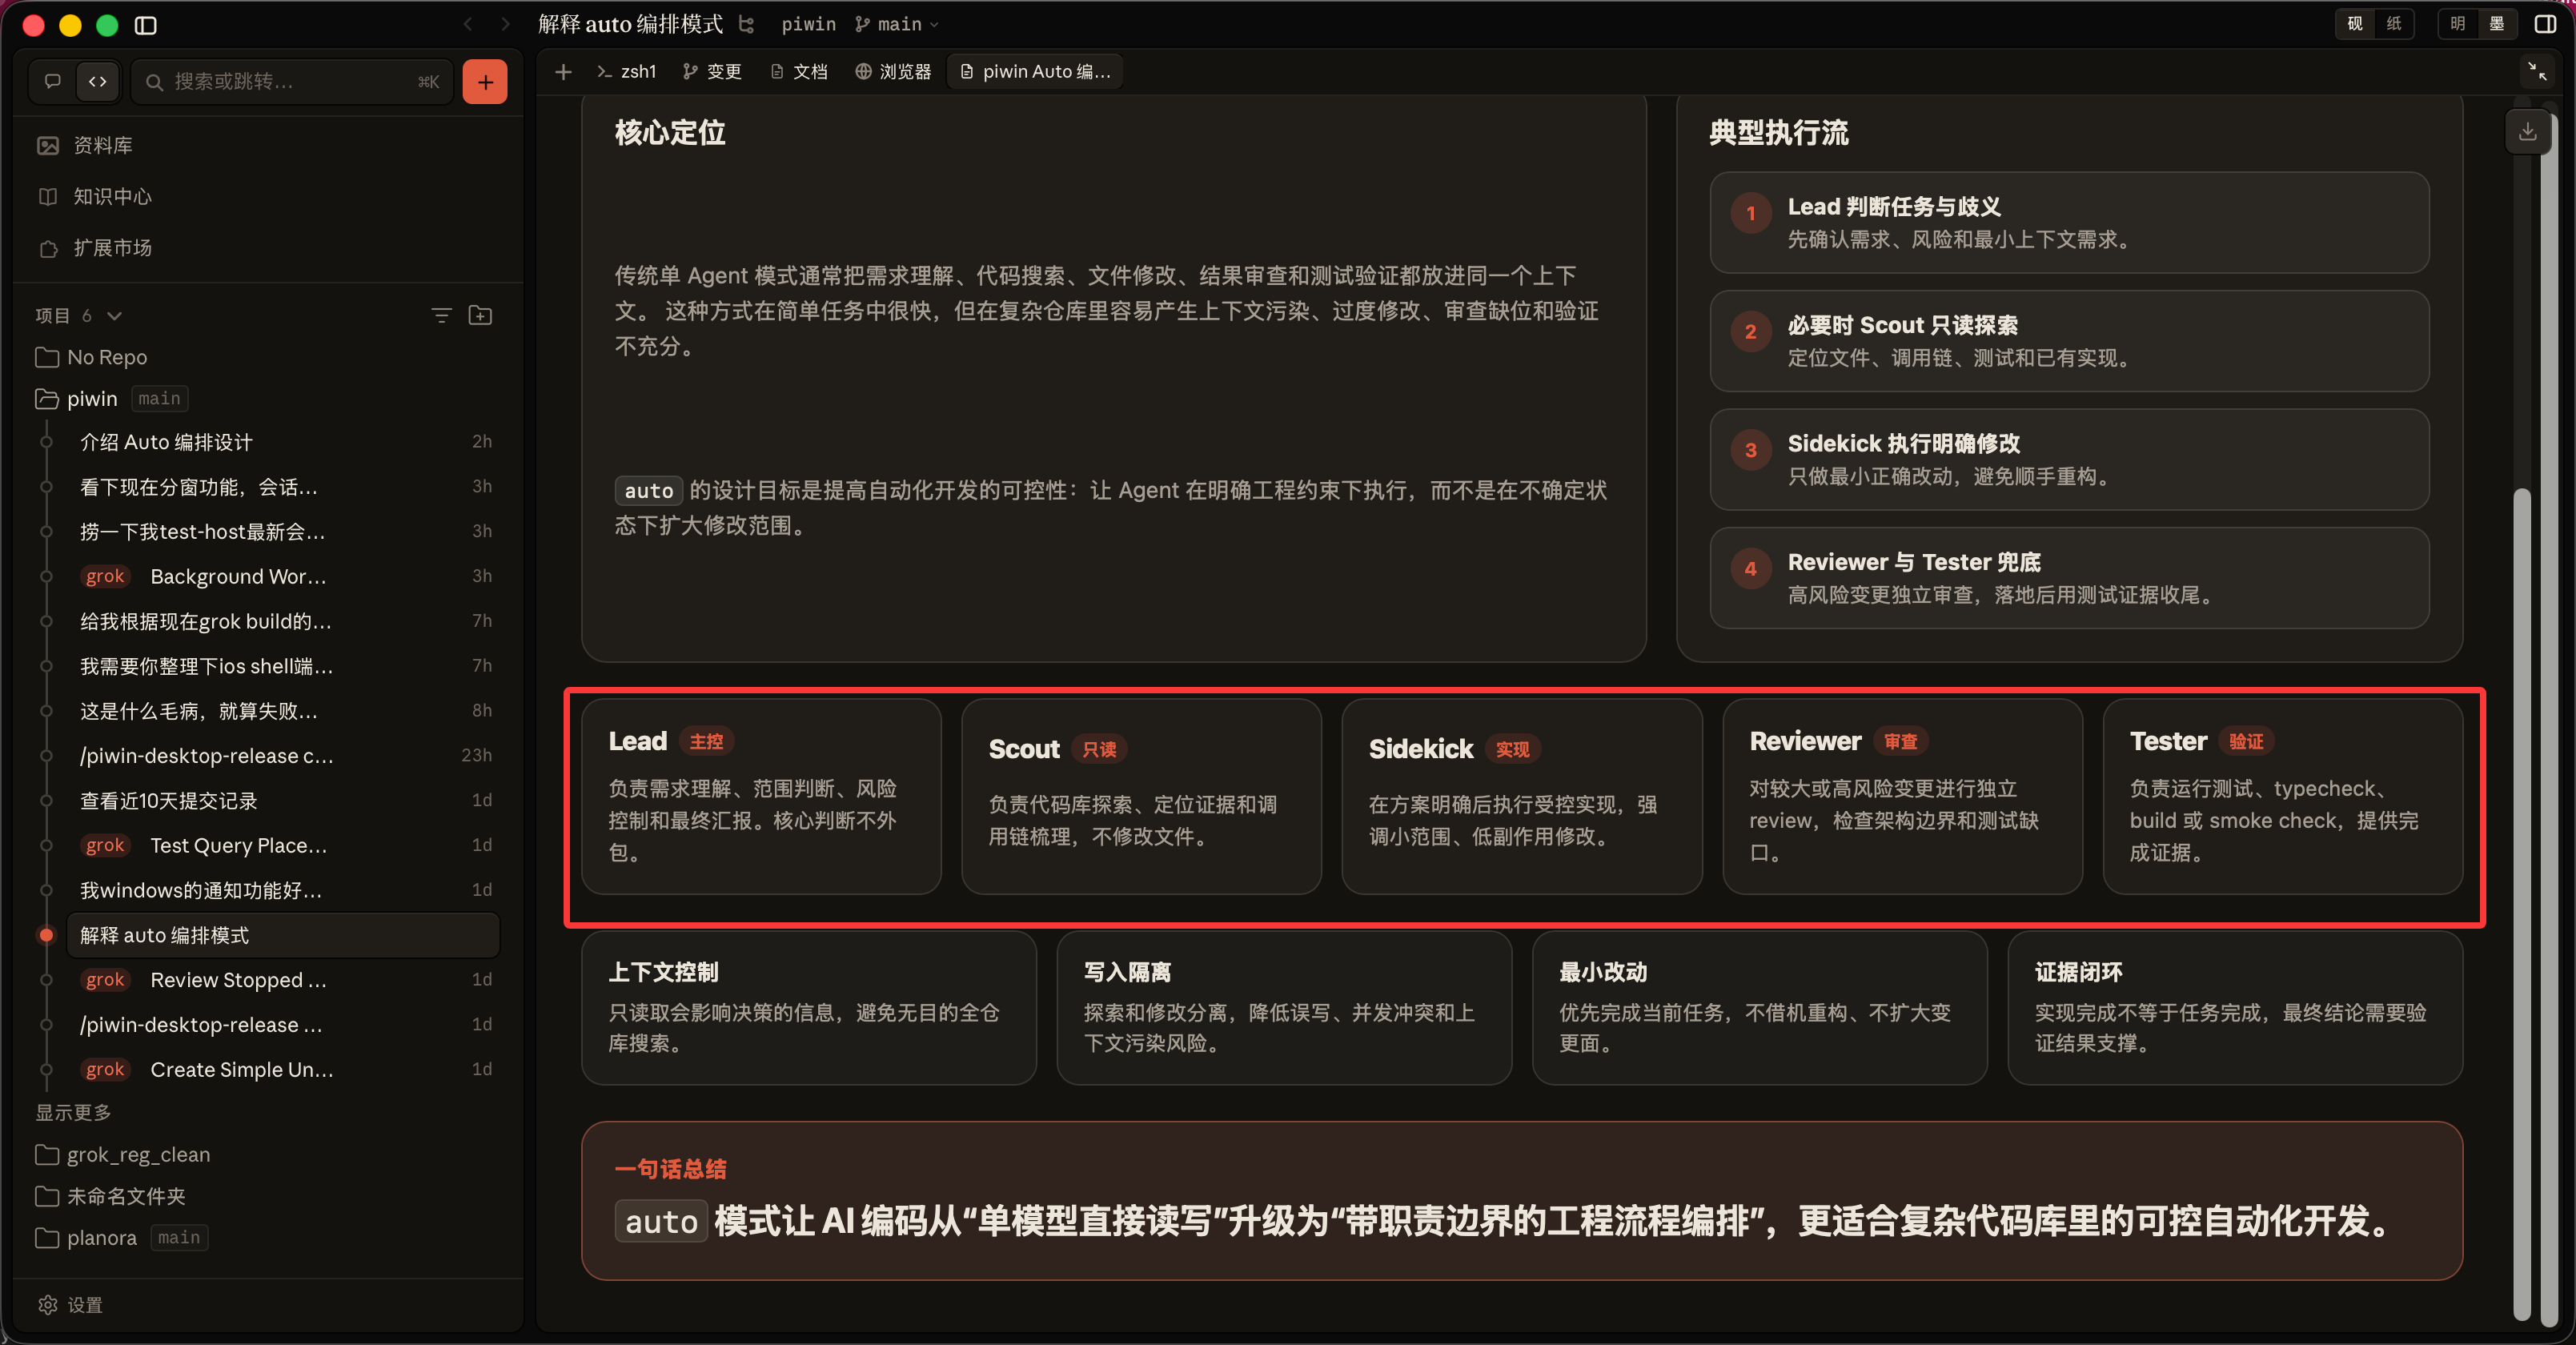
与"主模型主导一切"的传统做法相比,这种分工的收益在于成本而非 token 数量:总 token 消耗未必减少,但其中相当一部分转移到了单价更低的模型上。
各角色对模型能力的要求不同,可以分别配置:
| 角色 | 对模型的要求 | 原帖给出的配置示例 |
|---|---|---|
| Lead | 最强的判断与规划能力 | Fable 5.1 |
| Scout | 速度优先 | SWE-1.6、Gemini 3.6 Flash |
| Sidekick | 性价比与执行稳定性 | Flash 级模型、Grok |
| Reviewer | 独立而细致的审查能力 | Luna |
| Tester | 较强的 agentic 能力(可能需要驱动 E2E) | 按需选择 |
分工的关键在于划清什么可以下放。Auto 的路由规则是:
- 位置未知、证据不足 → Scout;
- 方案已定、实现机械 → Sidekick;
- 架构取舍、需求歧义、体验判断 → Lead 自己完成,判断永不下放。
Lead 与 Sidekick 之间不共享完整的会话记录,只交换 brief(自包含的任务简报:目标、范围、约束、成功标准)与 result。这既避免了 Sidekick 被主会话历史污染,也避免了反复重发上下文导致的缓存失效。
6 约束四:单写者、隔离工作树与后台验证
6.1 为什么判断不能下放
"判断永不下放"并非出于保守,而有实验依据。Devin 团队在一个跨团队的 React/Redux 搜索栏任务中,尝试把判断型工作交给便宜模型,结果如图 7 所示。
成本只下降了 28%,得分却从 54 跌至 27。这说明真正有效的降本方式不是让便宜模型代替 Lead 思考,而是让 Lead 保留判断、计划、歧义处理与终审,只把明确而机械的实现交出去。
6.2 为什么写操作必须单线程
同一实验得出的另一条结论是:写操作应尽量保持单线程。额外的代理应当优先贡献"智力"(搜索、审查、验证),而不是同时修改同一份代码。
读代码与写代码的并发性质不同。只读的 Scout 与 Reviewer 可以任意并行;多个写者同时修改同一仓库,则会带来文件冲突、基线提交漂移,以及"审查时看到的快照"与"实际合入的内容"不一致的问题。
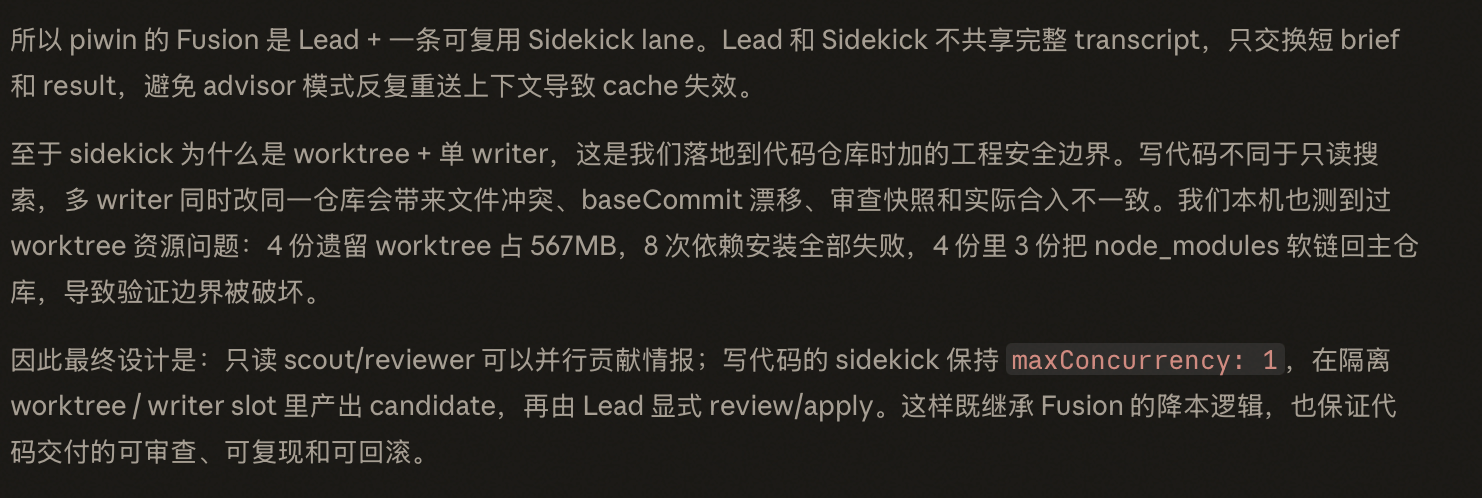
Piwin 在实现过程中也实际观测到了并行工作树的资源问题:
- 4 份遗留的 worktree 占用了 567 MB 磁盘;
- 8 次依赖安装全部失败;
- 4 份 worktree 中有 3 份把
node_modules软链接回了主仓库,验证边界因此被破坏——在隔离环境中跑的测试,实际用的是主仓库的依赖。
最终的设计是:
- 只读的 Scout 与 Reviewer 可以并行贡献信息;
- 写代码的 Sidekick 保持
maxConcurrency: 1,在隔离的 worktree 中产出候选改动(candidate); - 同一条 Sidekick lane 在会话内持续复用,修改意见以新的 brief 发回同一个 Sidekick;
- 候选改动由 Lead 显式审查并应用,一份候选只做一次决定。
这样既继承了 Fusion 的降本逻辑,也保证了交付的可审查、可复现、可回滚。
6.3 规模闸:谁来审查
Lead 自审适用于小改动。当候选改动超过以下任一上限时,Host 会拒绝 Lead 的自审,强制要求启动独立的只读 Reviewer:
| 上限 | 默认值 |
|---|---|
| 涉及文件数 | 5 |
| 改动行数 | 300 |
这是整个方案中唯一由 Host 强制执行的路由规则,阈值可在设置中调整。Reviewer 给出 approved、changes-requested 或 blocked 三种结论之一;同一改动的"修改—再审"循环不超过两轮,超出则停止并向用户说明。
6.4 Tester:不阻塞反馈的后台验证
改动合入后,Lead 不等待测试结果,而是立即告诉用户改了什么、可以手动尝试什么;与此同时启动 Tester。
Tester 的设计有三个要点:
- 基线是工作区快照。 Tester 运行在独立 worktree 中,基线为当前工作区的快照(包含未提交的改动),它自己的任何编辑都不会被合入。
- 目标是行为证据,不是覆盖率。 优先执行真实行为——运行命令,或在非默认端口启动预览并驱动界面,留下输出或截图;其次才是与改动范围相关的既有测试与类型检查。只有在复现了失败时才补充回归测试。
- 报告异步回流。 报告第一行为
pass、fail或blocked,正文逐条给出验收标准对应的证据。如果用户的新消息将改变被测代码,Lead 会取消正在运行的 Tester,在改动后重新启动。
长时间的测试因此不再占用用户等待的时间。
7 实现要点:纪律的渐进式披露
把上述全部规则一次性写进系统提示,本身就会制造上下文污染。Auto 因此把纪律分三层披露:
| 层级 | 内容 | 注入时机 |
|---|---|---|
| L0 常驻纪律 | Goal 行、信息收集限制、编码准则、路由规则 | 始终在场,保持简短 |
| L1 角色手册 | 每个角色的完整操作循环 | 会话中首次使用该角色前,由 Lead 调用 piwin_scheme_playbook 获取 |
| L2 下一步提示 | 当前候选改动应执行的具体调用 | 附在工具返回结果上 |
Lead 只在需要时才读到某个角色的详细流程;审查、应用、启动 Tester 这类步骤性的指引,随工具结果在恰当的时刻出现,而不必常驻上下文。这与约束二是同一原则在提示词层面的应用。
8 使用与配置
在 Composer 输入框上方的编排方案下拉中选择 Auto。方案按消息生效,可以随时切换。
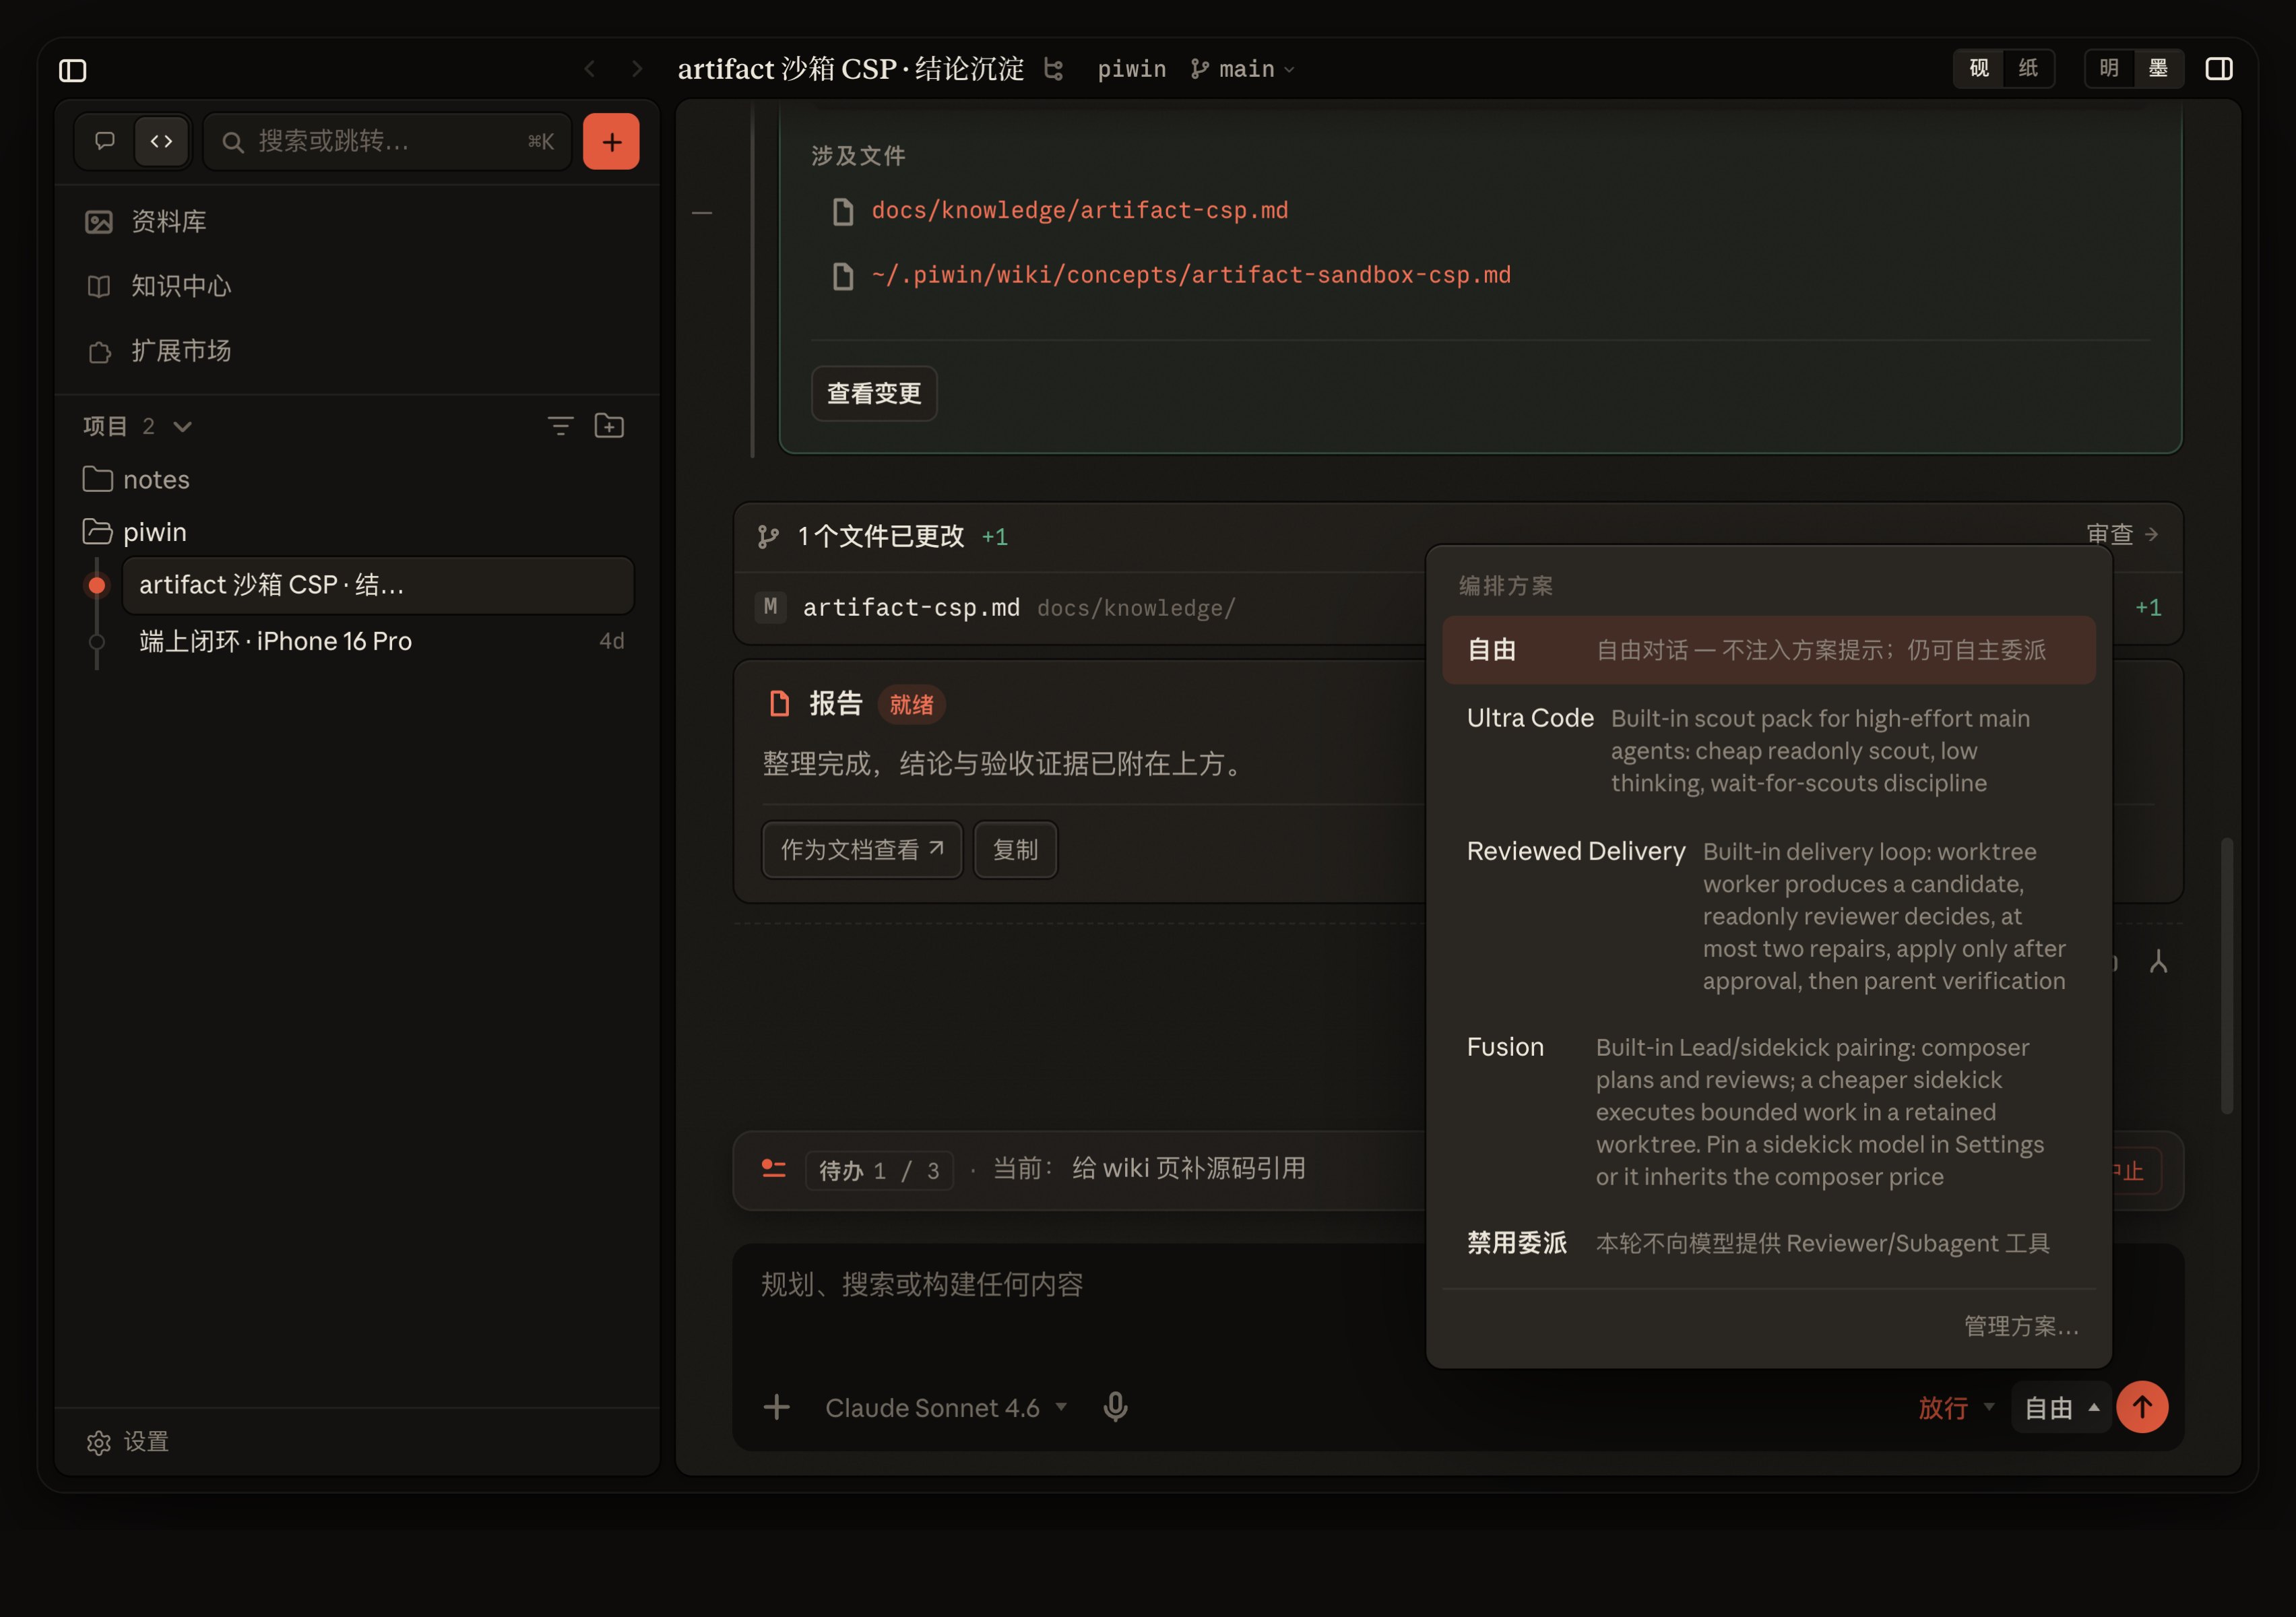
Auto 的成员模型引用自各自的来源方案,不在 Auto 里单独配置:
| 想调整的角色 | 到哪里配置 |
|---|---|
| Lead | Composer 中当前选择的主模型 |
| Scout | Ultra Code 方案的 scout 成员 |
| Sidekick | Fusion 方案的 sidekick 成员 |
| Reviewer | Reviewed Delivery 方案的 reviewer 成员 |
选中对应方案后点击旁边的「编辑 / 模型配置」即可修改,各角色的选型建议见 §5 的表格。
记得为执行角色单独选模型
成员未单独配置模型时会继承主模型。此时 Scout 与 Sidekick 用的仍是最贵的那个模型,"强模型判断、便宜模型执行"的成本结构就不成立了。
9 讨论与局限
术语与度量。 "上下文污染"与"有效信息密度"在本文中是定性概念。图 5 是以文件计数的示意模型,并非对注意力分配的测量;本文没有给出污染程度与任务成功率之间的定量关系。
压缩质量依赖模型判断。 无论是 Scout 的报告还是上下文压缩,都假定模型能够判断哪些信息重要。这一假定在多大程度上成立,目前缺乏系统的验证。Auto 的对策是要求 Scout 返回可核对的 file:line 引用,并由 Lead 抽查,但抽查不能完全排除遗漏。
实验证据的外推。 6.1 节引用的实验来自单一任务,结论的方向清晰,具体数值不宜直接推广到其他任务类型与模型组合。
单写者的代价。 maxConcurrency: 1 以吞吐量换取了可审查性。对于可以清晰拆分、互不依赖的大型任务,这一限制会延长总耗时。
路由仍依赖 Lead。 除规模闸外,所有路由决策都由 Lead 做出。Lead 判断失误——该派 Scout 时自己大范围读取,或把需要判断的工作交给 Sidekick——方案的收益就会打折扣。
10 结语
Auto 的各个组成部分都有明确的出处:最小读取规则来自社区实践,上下文隔离是业界共识,角色分工与单写者原则来自 Devin 的 Fusion。它所做的工作是把这些做法组合成一套由 Host 强制执行的协议,而不是寄望于模型自觉遵守。
整个设计可以归结为一句话:

把写操作收敛为单一写者,把验证与审查变成独立的证据流。
欢迎在原帖中批评与讨论。
参考资料
- OpenAI. Multi-agent(Responses API 指南). https://developers.openai.com/api/docs/guides/responses-multi-agent
- Cursor. Subagents 官方文档. https://cursor.com/docs/subagents
- Anthropic. Effective context engineering for AI agents. 2025. https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents
- Hong, K., Troynikov, A., Huber, J. Context Rot: How Increasing Input Tokens Impacts LLM Performance. Chroma Research, 2025. https://research.trychroma.com/context-rot
- Breunig, D. How Long Contexts Fail. 2025. https://www.dbreunig.com/2025/06/22/how-contexts-fail-and-how-to-fix-them.html
- Liu, N. F., et al. Lost in the Middle: How Language Models Use Long Contexts. TACL, 2024. https://arxiv.org/abs/2307.03172
- LINUX DO 社区. 如何在 DSH 里提高 DS4.1F 的效率,根治多动症和发散行为(#21 楼
agent.md). https://linux.do/t/topic/2967866/21 - Cognition. Devin Fusion 相关实验,转引自原帖截图。
- Lindenbauer, T., et al. (JetBrains Research). The Complexity Trap: Simple Observation Masking Is as Efficient as LLM Summarization for Agent Context Management. arXiv:2508.21433, 2025. 文中报告:SWE-agent 上观察结果(文件内容、命令输出等)平均约占每轮 token 的约 84%。 https://arxiv.org/abs/2508.21433 · https://blog.jetbrains.com/research/2025/12/efficient-context-management/